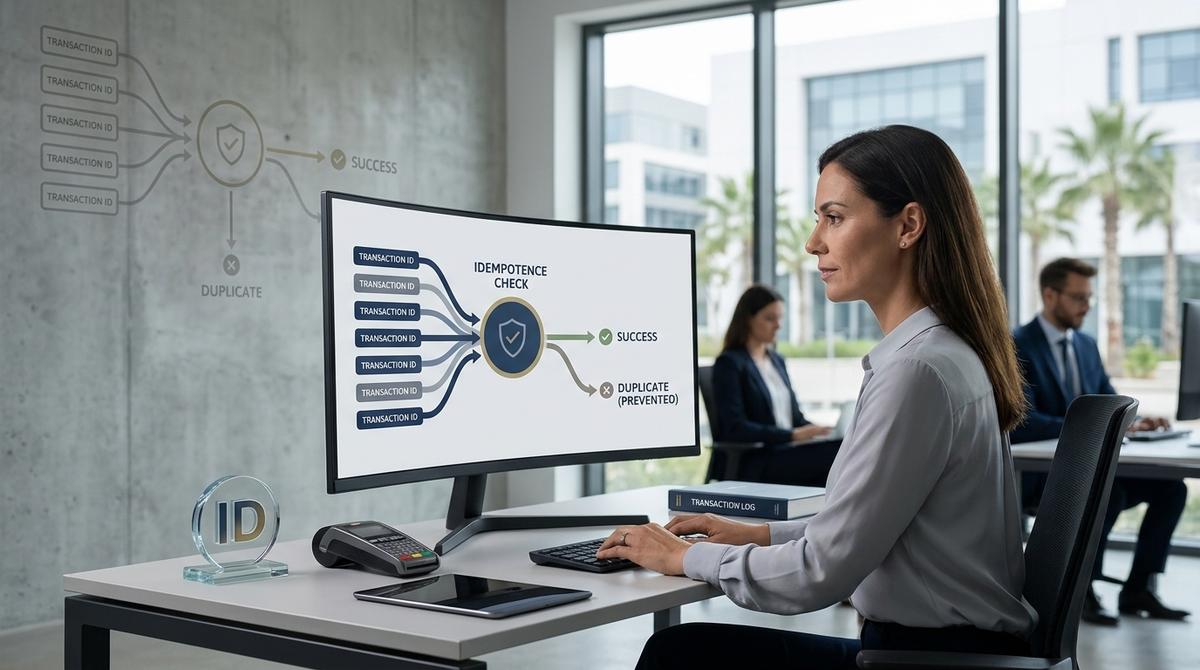
Idempotence et gestion des doublons de transaction dans un système de paiement
Dans un système de paiement numérique, quelques millisecondes d’incertitude peuvent suffire à provoquer un incident financier. Un client clique deux fois sur le bouton « Payer », une requête expire avant de recevoir sa réponse ou un serveur relance automatiquement une opération dont le résultat demeure inconnu. Dans ces situations, une même intention de paiement risque de déclencher plusieurs tentatives de traitement, voire plusieurs débits.
Ce phénomène représente un enjeu majeur pour les plateformes de commerce électronique, les portefeuilles électroniques, les passerelles de paiement et les infrastructures financières. Une transaction dupliquée peut entraîner des pertes financières, des réclamations, des remboursements supplémentaires et une dégradation de la confiance des utilisateurs.
Pour prévenir ces dysfonctionnements, l’idempotence constitue un mécanisme fondamental de l’ingénierie des paiements. Elle permet de répéter une requête sans reproduire les effets financiers d’une opération déjà exécutée. Associée à une gestion rigoureuse des identifiants, des états transactionnels et des mécanismes de reprise, elle contribue à rendre les systèmes de paiement plus résilients, cohérents et prévisibles.
1. Comprendre l’idempotence dans les systèmes de paiement
1.1. Définition de l’idempotence et rôle dans la fiabilité des transactions
En informatique, une opération est dite idempotente lorsque son exécution répétée produit le même effet observable que sa première exécution, dans le périmètre défini par le système. Autrement dit, répéter une même demande ne doit pas provoquer une multiplication de ses conséquences.
Dans un système de paiement, cette propriété est particulièrement importante. Lorsqu’un client demande le paiement de 500 dirhams, le système doit pouvoir reconnaître les nouvelles tentatives correspondant à cette même opération et éviter de débiter le compte une seconde fois.
L’idempotence ne signifie pas nécessairement que toutes les réponses techniques sont identiques dans leur forme. Elle signifie surtout que la répétition d’une même intention de paiement ne déclenche pas un nouvel effet financier non souhaité.
Prenons un exemple concret. Un client effectue un achat sur une boutique en ligne. La passerelle de paiement reçoit la demande, traite le paiement et confirme la transaction. Cependant, la réponse ne parvient jamais au navigateur en raison d’une interruption réseau. Le client pense alors que le paiement a échoué et clique une nouvelle fois sur le bouton de validation.
Sans mécanisme d’idempotence, le serveur peut interpréter cette seconde requête comme une nouvelle opération et lancer un autre débit. Avec une clé d’idempotence correctement implémentée, il reconnaît la demande initiale et restitue le résultat déjà enregistré, sans déclencher une nouvelle opération financière.
Cette propriété repose généralement sur plusieurs composants complémentaires :
Une clé d’idempotence permettant d’identifier une opération logique unique.
Un stockage persistant conservant les clés utilisées et les résultats associés.
Une logique de contrôle empêchant plusieurs traitements concurrents de produire des effets financiers répétés.
Un mécanisme de restitution du résultat permettant de répondre aux nouvelles tentatives sans réexécuter le paiement.
L’idempotence contribue ainsi à maîtriser les effets des répétitions, mais elle ne remplace pas les autres mécanismes de sécurité. L’authentification, l’autorisation, la détection de fraude et la validation des montants restent indispensables.
1.2. Pourquoi les doublons apparaissent-ils lors d’un paiement en ligne ?
Les doublons transactionnels ne proviennent pas uniquement d’une erreur de programmation. Ils peuvent résulter du comportement normal d’une infrastructure distribuée, dans laquelle plusieurs services communiquent au moyen de réseaux dont la disponibilité et les délais ne sont jamais parfaitement garantis.
Le premier scénario concerne le timeout, c’est-à-dire l’expiration du délai d’attente d’une réponse. Une plateforme transmet une demande à son prestataire de paiement, mais ne reçoit aucune confirmation dans le temps imparti. Pourtant, la transaction peut avoir été exécutée avec succès. Si le système relance immédiatement la demande sans vérifier son identité, un second débit devient possible.
Le deuxième scénario implique les actions répétées de l’utilisateur. Une connexion lente, un bouton qui semble inactif ou une page qui ne se recharge pas peuvent inciter le client à cliquer plusieurs fois. La désactivation visuelle du bouton réduit ce risque, mais elle ne suffit pas : plusieurs requêtes peuvent déjà être en transit, ou une autre source peut soumettre la même opération.
Le troisième scénario concerne les mécanismes automatiques de reprise, communément appelés retries. Ces mécanismes sont utiles pour surmonter les erreurs temporaires. Toutefois, une nouvelle tentative ne doit pas être assimilée à une nouvelle intention de paiement.
Enfin, les notifications envoyées par les prestataires peuvent elles aussi être dupliquées. Un fournisseur de paiement peut transmettre plusieurs fois le même webhook lorsqu’il ne reçoit pas l’accusé de réception attendu. Si le système marchand traite chaque notification comme un événement inédit, il risque de comptabiliser plusieurs fois une seule transaction.
Ces situations illustrent une difficulté fondamentale : l’absence de réponse ne prouve pas l’échec d’une opération. Dans un environnement distribué, il faut pouvoir distinguer une transaction réellement échouée d’une transaction exécutée dont la confirmation a été perdue.
L’idempotence apporte une réponse à cette incertitude en permettant au système de reconnaître les opérations répétées et de préserver la cohérence des traitements.
2. Mettre en place une stratégie robuste de prévention des doublons
2.1. Clés d’idempotence, identifiants uniques et contrôle de l’état des transactions
La clé d’idempotence constitue l’un des principaux instruments de prévention des doubles paiements. Il s’agit d’un identifiant unique associé à une opération logique, généralement généré par le serveur marchand ou par le composant responsable de l’orchestration du paiement.
Lorsqu’une demande est envoyée à une passerelle de paiement, cette clé accompagne la requête. Si la même opération doit être répétée à la suite d’un timeout ou d’une interruption temporaire, le système réutilise la clé initiale.
À l’inverse, un nouveau paiement légitime doit recevoir une nouvelle clé.
Une clé peut prendre la forme d’une chaîne aléatoire difficile à deviner ou être construite à partir d’un identifiant interne unique. Il est généralement préférable d’utiliser un identifiant opaque, suffisamment robuste pour éviter les collisions et ne révélant pas d’informations sensibles.
Le fonctionnement peut être illustré par le scénario suivant :
Le serveur crée une opération de paiement identifiée par une clé d’idempotence.
Il enregistre cette opération dans sa base de données avec son montant, sa devise et son état initial.
Il transmet la demande au prestataire de paiement avec la même clé.
Si une requête identique arrive de nouveau, le serveur recherche l’opération existante.
Si le paiement a déjà été exécuté, le système restitue le résultat connu au lieu de lancer un nouveau débit.
Un point mérite une attention particulière : la clé doit être associée au contexte de la demande. Si un client réutilise accidentellement la même clé pour un paiement de 500 dirhams, puis pour un paiement de 900 dirhams, le système ne doit pas traiter silencieusement la seconde requête comme une simple répétition de la première.
Il convient donc de conserver une empreinte des paramètres significatifs de la demande, par exemple le montant, la devise, le compte marchand et l’opération concernée. Lorsqu’une clé existante est présentée avec un contenu incompatible, le système doit rejeter la requête ou la placer dans un processus de résolution approprié.
La durée de conservation des clés constitue également un paramètre essentiel. Si elles sont supprimées trop rapidement, une ancienne requête répétée peut être interprétée comme une nouvelle opération. La durée de rétention doit tenir compte des délais de reprise, des contraintes du prestataire et des exigences de rapprochement.
Il est donc recommandé de distinguer trois identifiants complémentaires :
L’identifiant métier, qui représente la commande ou l’intention d’achat.
La clé d’idempotence, qui permet de reconnaître les répétitions d’une même opération.
L’identifiant du prestataire, qui référence la transaction dans l’infrastructure externe de paiement.
Ces identifiants ne remplissent pas exactement la même fonction. Leur articulation permet de suivre le cycle de vie d’un paiement depuis la commande initiale jusqu’à sa confirmation et à son rapprochement financier.
2.2. Verrous, contraintes de base de données et traitement concurrent des requêtes
Une clé d’idempotence ne suffit pas si plusieurs requêtes peuvent être traitées simultanément sans coordination. Deux serveurs peuvent recevoir la même demande presque au même instant, constater qu’aucune opération n’est encore enregistrée et tenter chacun de lancer le paiement.
Ce phénomène correspond à une condition de concurrence, ou race condition. Il peut compromettre la garantie d’unicité si le système ne protège pas correctement la phase de création et de traitement de la transaction.
La première ligne de défense consiste à utiliser des contraintes d’unicité dans la base de données. Une clé d’idempotence peut, par exemple, être associée à une contrainte unique dans le périmètre du compte marchand. Ainsi, deux requêtes concurrentes ne peuvent pas créer deux enregistrements distincts avec la même clé.
La logique applicative doit ensuite gérer proprement le conflit. Si une requête échoue parce que la clé existe déjà, elle doit relire l’enregistrement correspondant et déterminer si l’opération est en cours, terminée ou nécessite une vérification complémentaire.
Les transactions de base de données permettent également de rendre atomiques certaines étapes internes. L’enregistrement de l’intention de paiement et de ses paramètres peut être réalisé dans une transaction SQL, afin d’éviter qu’une opération ne soit partiellement créée à la suite d’une erreur.
Toutefois, une transaction SQL ne peut pas rendre atomiques, à elle seule, un changement dans la base de données locale et un débit effectué chez un prestataire externe. Ces deux systèmes sont distincts. Une architecture robuste doit donc prévoir une coordination adaptée, ainsi qu’une procédure de récupération en cas d’interruption.
Les verrous distribués peuvent apporter une protection supplémentaire dans certains contextes, mais ils doivent être utilisés avec discernement. Une expiration de verrou, une panne ou un problème de synchronisation peuvent laisser subsister des scénarios de concurrence. Ils ne doivent pas remplacer les contraintes d’unicité et la persistance des états transactionnels.
Une modélisation explicite du cycle de vie du paiement constitue une autre bonne pratique. Les états peuvent notamment comprendre :
CREATED : l’intention de paiement est enregistrée.
PROCESSING : le traitement a commencé.
SUCCEEDED : le paiement a été confirmé comme réussi.
FAILED : l’échec est confirmé.
UNKNOWN : le résultat ne peut pas encore être établi.
REFUNDED : un remboursement a été confirmé.
Ces états doivent être définis selon les capacités du prestataire utilisé. Ils ne sont pas tous nécessairement exposés directement par son API.
Le statut UNKNOWN est particulièrement important. Il évite de confondre une absence de réponse avec un échec définitif. Lorsqu’une opération demeure incertaine, le système doit rechercher son résultat auprès du prestataire avant d’autoriser une nouvelle tentative susceptible de provoquer un autre débit.
Cette combinaison de contraintes de base de données, de contrôle de concurrence et de transitions d’état constitue le socle d’une prévention durable des doublons.
3. Gérer les erreurs, les reprises et la réconciliation des paiements
3.1. Timeouts, retries et réponses incertaines : comment éviter une double facturation ?
Dans une infrastructure de paiement, les erreurs temporaires sont inévitables. Une passerelle peut être momentanément indisponible, une connexion peut être interrompue ou un serveur peut redémarrer pendant le traitement d’une transaction.
L’objectif n’est donc pas de supprimer toutes les erreurs, mais de concevoir un système capable de les absorber sans compromettre l’intégrité financière.
La première règle consiste à différencier les erreurs dont le résultat est connu de celles qui laissent planer une incertitude.
Une erreur de validation indiquant que la requête est invalide peut, par exemple, permettre de conclure que le paiement n’a pas été accepté. En revanche, un timeout survenant après l’envoi de la demande ne permet pas nécessairement de déterminer si le débit a eu lieu.
Dans ce second cas, relancer immédiatement l’opération avec une nouvelle clé est une mauvaise pratique. La bonne approche consiste à conserver la clé initiale et à interroger le prestataire, si son API le permet, pour retrouver l’état de la transaction. Si cette vérification n’aboutit pas, l’opération doit rester dans un état incertain jusqu’à ce que des informations suffisamment fiables permettent de la résoudre.
Les reprises automatiques doivent elles aussi être encadrées. Une stratégie courante utilise un délai progressif entre les tentatives, appelé exponential backoff. Le délai augmente après chaque échec, ce qui limite la surcharge du service distant. Une variation aléatoire, appelée jitter, peut être ajoutée afin d’éviter que de nombreuses requêtes ne repartent simultanément.
Ces mécanismes de temporisation améliorent la résilience, mais ne garantissent pas à eux seuls l’absence de doublons. La protection repose toujours sur la réutilisation de la même clé d’idempotence et sur la capacité à identifier l’opération initiale.
Le traitement des webhooks exige une discipline similaire. Lorsqu’une notification de paiement est reçue, le système doit vérifier son authenticité, enregistrer son identifiant d’événement et empêcher le traitement répété d’un événement déjà consommé.
Il est préférable de séparer la réception de la notification de son traitement métier. Le serveur peut enregistrer l’événement dans une table persistante, puis le transmettre à un processus de traitement asynchrone. Une contrainte d’unicité sur l’identifiant de l’événement permet alors d’éviter que la même notification ne soit appliquée plusieurs fois.
Il faut néanmoins distinguer l’identifiant d’un webhook de celui d’une transaction. Plusieurs événements légitimes peuvent concerner un même paiement, par exemple une autorisation, une capture, puis un remboursement. Dédupliquer tous les événements sur la seule base de l’identifiant de transaction risquerait de supprimer des changements d’état valides.
La logique doit donc reconnaître les répétitions d’un même événement tout en acceptant les événements distincts et légitimes associés à la transaction.
Enfin, les systèmes de paiement doivent éviter de promettre une garantie absolue d’exécution « exactement une fois » lorsque plusieurs infrastructures indépendantes interviennent. En pratique, cette garantie est généralement obtenue au moyen de mécanismes combinés : identifiants stables, déduplication, états persistants, reprise contrôlée et réconciliation.
3.2. Journalisation, rapprochement financier et bonnes pratiques de supervision
Même avec une architecture soigneusement conçue, des incohérences peuvent survenir. Une notification peut être retardée, un prestataire peut connaître un incident ou un traitement peut rester bloqué dans un état intermédiaire.
C’est pourquoi la prévention des doublons doit être complétée par une stratégie de supervision et de rapprochement financier.
La journalisation permet de reconstituer le parcours d’une opération. Pour chaque paiement, le système devrait conserver les éléments utiles à son diagnostic : identifiant de commande, clé d’idempotence, identifiant du prestataire, montant, devise, horodatages, transitions d’état et références aux événements reçus.
Les données sensibles, notamment les informations d’authentification et les données complètes de carte bancaire, ne doivent pas être inscrites dans les journaux. La traçabilité doit être conçue de manière à faciliter les investigations sans compromettre la confidentialité ou la sécurité des utilisateurs.
La supervision doit ensuite s’appuyer sur des indicateurs pertinents. Parmi les plus utiles figurent le nombre de tentatives répétées, la fréquence des timeouts, le volume de transactions en état incertain, le nombre de webhooks dupliqués et le délai moyen de résolution des opérations.
Des seuils d’alerte peuvent être définis pour détecter une anomalie. Une hausse soudaine des transactions incertaines ou des demandes répétées peut révéler une panne du prestataire, un problème réseau ou un défaut dans le mécanisme de reprise.
Le rapprochement financier représente une autre composante indispensable. Il consiste à comparer les enregistrements internes avec les données de règlement, les rapports du prestataire ou les relevés disponibles. Cette opération permet de repérer les paiements présents chez le prestataire mais absents du système marchand, les transactions comptabilisées plusieurs fois et les remboursements dont l’état demeure incohérent.
En cas de divergence, le système doit disposer d’une procédure d’investigation clairement définie. Selon le cas, il peut être nécessaire de consulter l’état distant, de demander une vérification au prestataire ou de déclencher une intervention manuelle. Une correction ne doit pas être appliquée automatiquement sur la base d’une simple supposition.
Les opérations de remboursement méritent la même rigueur que les paiements initiaux. Un remboursement peut lui aussi être soumis à des timeouts, à des notifications répétées ou à des reprises automatiques. Il doit donc posséder son propre identifiant, être rattaché au paiement d’origine et bénéficier d’un mécanisme d’idempotence adapté.
Pour renforcer la fiabilité globale, plusieurs pratiques peuvent être intégrées à l’architecture :
Définir un identifiant stable pour chaque intention de paiement.
Imposer des contraintes d’unicité dans la base de données.
Conserver les états transactionnels et les résultats des opérations.
Réutiliser la même clé d’idempotence lors des reprises d’une requête.
Vérifier les transactions dont le résultat demeure incertain.
Dédupliquer les événements entrants sans ignorer les transitions légitimes.
Mettre en place des journaux sécurisés, des alertes et des procédures de rapprochement.
Tester les scénarios de panne, de concurrence et de répétition avant la mise en production.
Ces mesures ne constituent pas une simple couche de confort technique. Elles participent directement à la maîtrise du risque opérationnel et à la confiance accordée à la plateforme de paiement.
Conclusion
L’idempotence et la gestion des doublons constituent deux piliers de la fiabilité des systèmes de paiement. Elles permettent de limiter les doubles débits, de rendre les reprises plus sûres et de préserver la cohérence des opérations malgré les interruptions réseau, les erreurs temporaires et les notifications répétées.
Toutefois, une clé d’idempotence isolée ne suffit pas. Une implémentation robuste repose sur une architecture cohérente associant identifiants uniques, contraintes de base de données, gestion explicite des états, traitement contrôlé des webhooks et rapprochement financier.
Le principe essentiel est simple : une nouvelle tentative technique ne doit pas créer automatiquement une nouvelle opération financière. Le système doit d’abord déterminer si la demande correspond à une opération existante et, lorsque son résultat est incertain, chercher à lever cette incertitude avant de poursuivre.
Dans un secteur où la précision des flux monétaires conditionne la confiance des utilisateurs, l’idempotence n’est donc pas seulement une propriété logicielle. Elle représente une composante fondamentale de la résilience, de la traçabilité et de la sécurité opérationnelle d’une infrastructure de paiement.